Literature Review MAS · HITL Orchestrator
-
 © Studentisches Projekt
Agentische Pipeline für strukturierte wissenschaftliche Literaturreviews
Das Projekt entwickelt eine Multi-Agenten-Anwendung, die wissenschaftliche Literatur systematisch sucht, bewertet und für die weitere Analyse aufbereitet. Ein Human-in-the-Loop-Schritt bindet die Nutzerinnen und Nutzer gezielt in den automatisierten Ablauf ein.
Projektidee und Ablauf
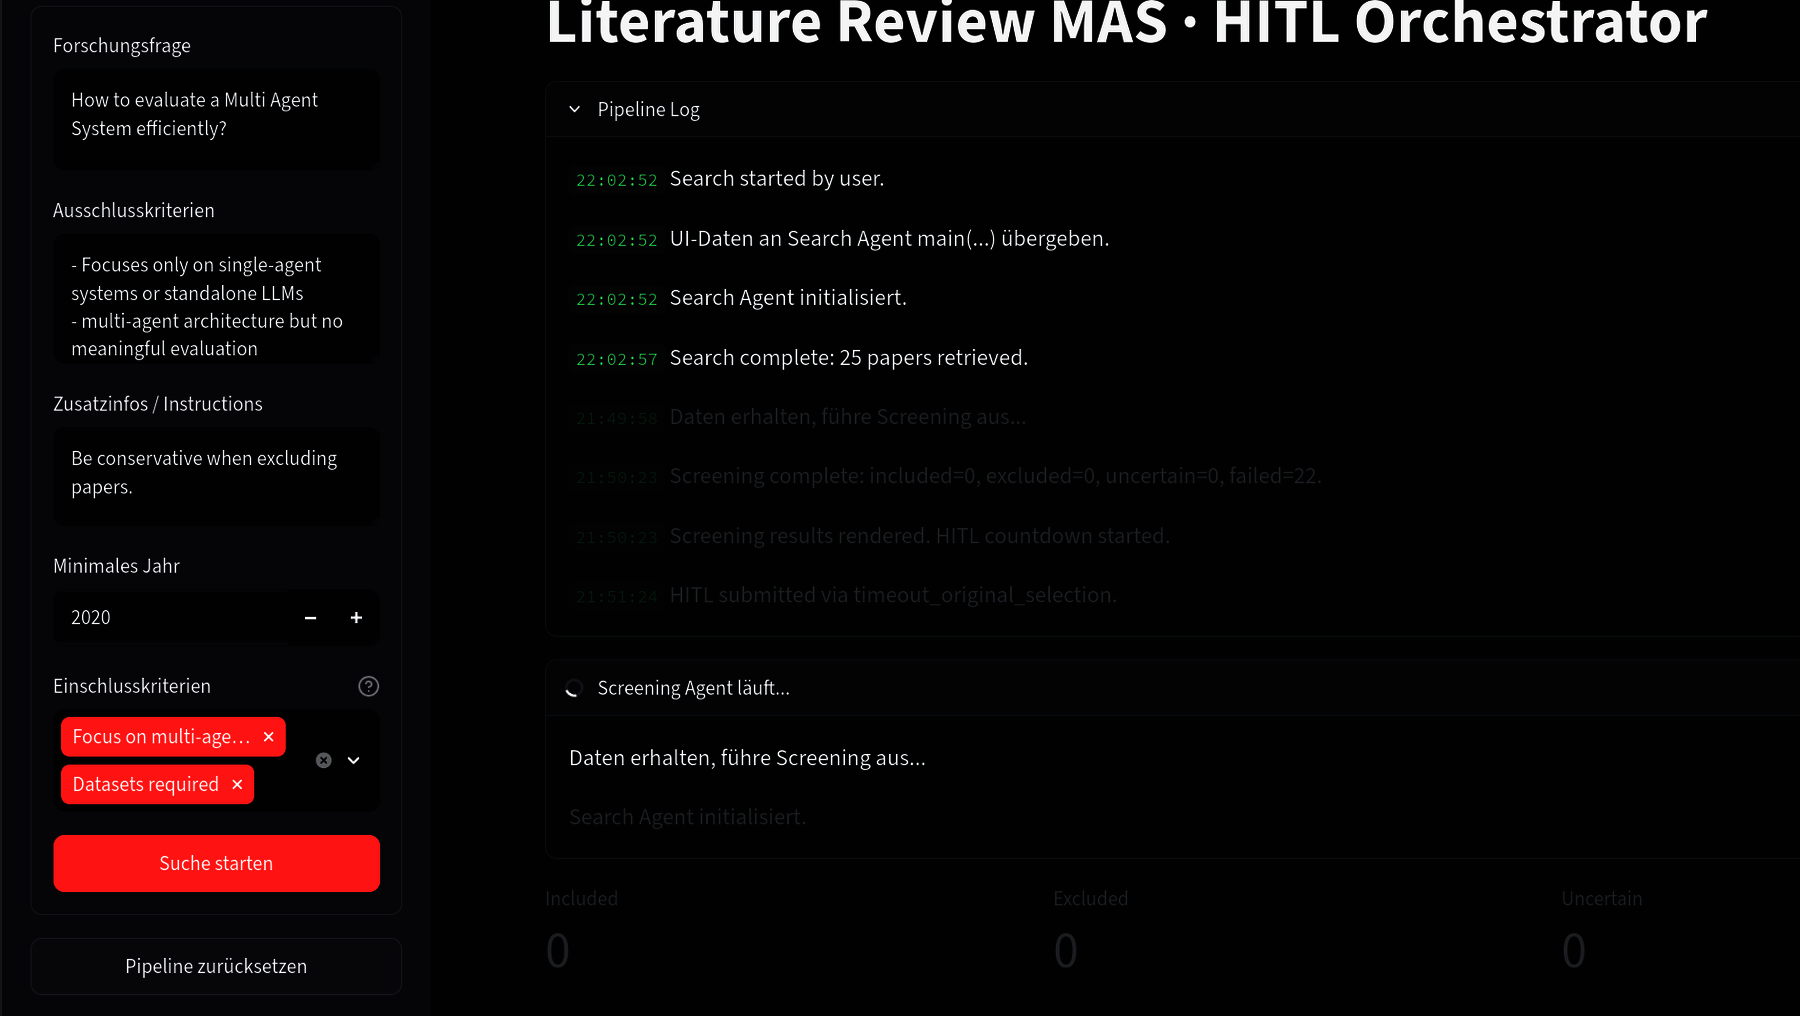
Ausgangspunkt ist ein Review-Protokoll: In der Oberfläche werden Forschungsfrage, Ein- und Ausschlusskriterien, Mindestjahr und zusätzliche Instruktionen definiert. Diese Angaben steuern den gesamten Workflow.
Der Search Agent recherchiert passende Publikationen. Der Screening Agent bewertet die Treffer anhand der Kriterien und ordnet sie in
Included, Excluded oder Uncertain ein. Danach lädt die Dokumentverarbeitung die relevanten PDFs und bereitet sie als RAG-Chunks auf. Der Extract Agent gewinnt daraus strukturiert zentrale Informationen wie Paper-Typ, Methode, Datensatz, Aufgabe, Hauptergebnisse, Limitationen und eine Confidence-Angabe.
Architektur und Mehrwert
Die Agenten sind über LangGraph in einer festen Pipeline orchestriert: Search, Screening, Document Processing und Extraction. Das Frontend basiert auf Streamlit, während FastAPI die Backend-Schnittstelle bereitstellt.
Strukturierte Datenmodelle sorgen dafür, dass Ergebnisse nachvollziehbar zwischen den Verarbeitungsschritten weitergegeben werden.
Der Human-in-the-Loop-Ansatz ergänzt die Automatisierung um kontrollierbare Entscheidungspunkte. Besonders der Extract
Agent macht die recherchierten Papers direkt vergleichbar, indem er die relevanten Inhalte tabellarisch aufbereitet; die extrahierten Daten können anschließend auch als CSV weiterverwendet werden.

